Проблема и гипотеза
При работе над долгими проектами с AI приходится повторять актуальные вводные и отделять действующие решения от старых предложений. Модель может воспринимать обсуждение как решение или переносить устаревший план в новое действие.
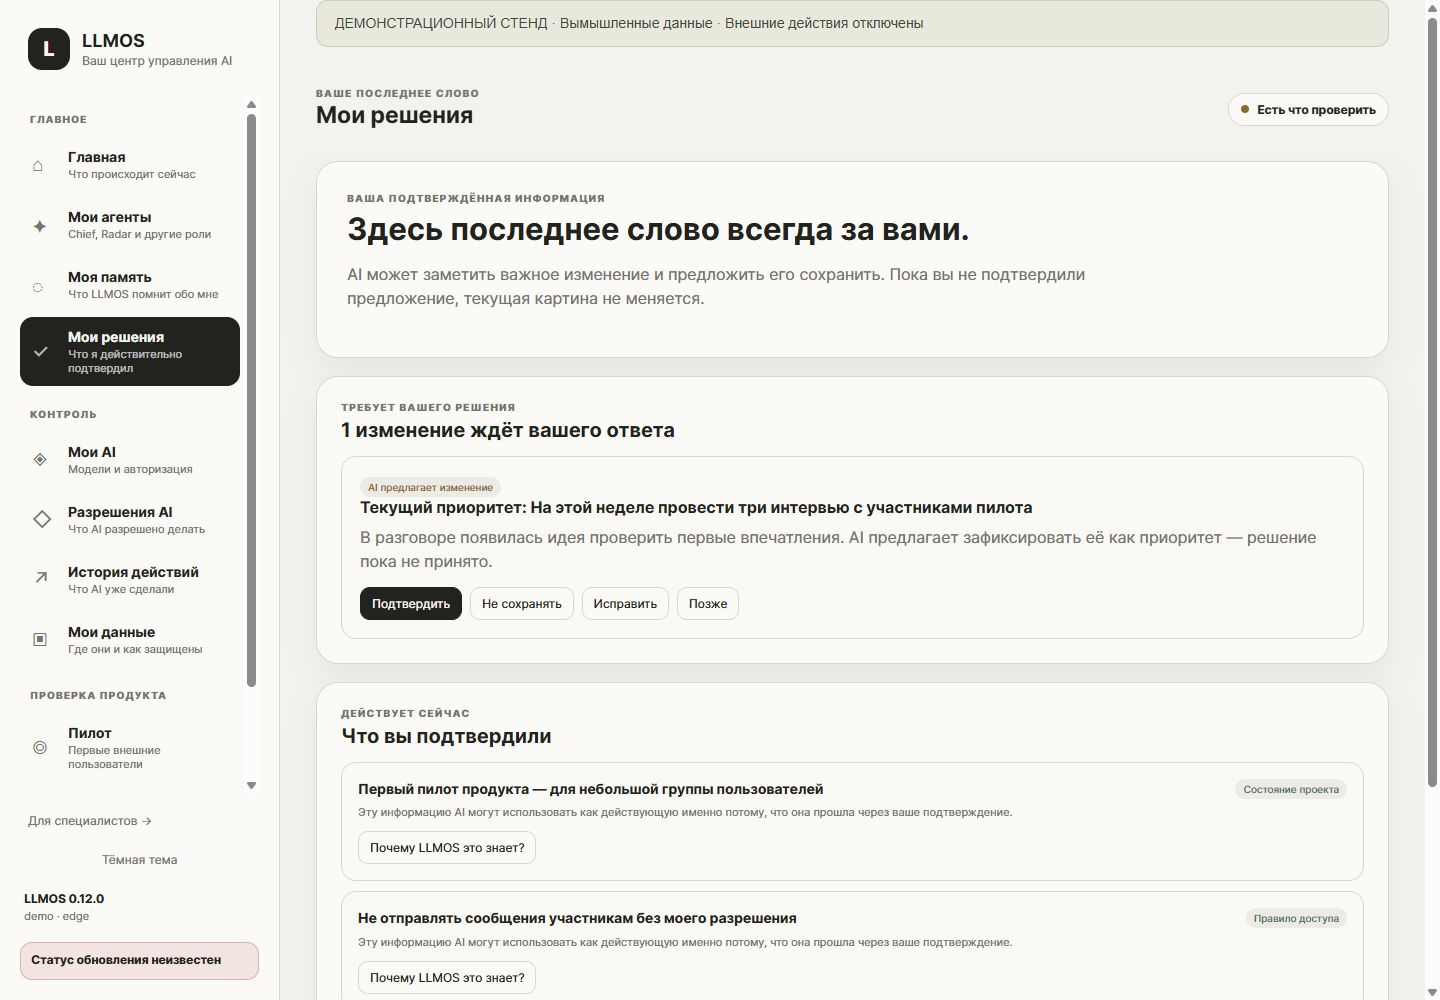
Гипотеза Managed Current State: явно управляемое актуальное состояние поможет сохранять контекст и контроль владельца. Предложение AI, подтверждённое решение, изменение состояния и разрешение на внешнее действие должны оставаться разными сущностями.
Что я проверял
Я сформулировал критерии и с помощью AI построил экспериментальный стенд M0. Первые ручные прогоны дали интересный результат, но обнаружились contamination и методологические дефекты. Я исключил их из доказательств и перешёл к автоматизированному stateless benchmark.
Положительный smoke-сигнал 12/15 оценок не стал основанием считать гипотезу подтверждённой. Он относился к небольшому набору сценариев. В последующих, более строгих проверках преимущество уменьшилось, а объективные и стрессовые проверки не показали отличий от сравниваемого подхода.
Более дорогой контекст также оказался ограничением. Использование одного provider для генерации и оценки — ещё одна методологическая граница этих экспериментов.
Что изменилось после результатов
Широкая гипотеза об универсальном преимуществе Managed Current State не подтвердилась. Я сузил направление исследования: экономия и обновление контекста, происхождение данных, полномочия владельца и границы действий AI.
Главный результат этапа — способ измерить гипотезу и изменить продуктовое решение на основании данных.
Кто что делал
Проект веду самостоятельно. Я определял проблему, гипотезу, критерии экспериментов, продуктовые и архитектурные границы. Сам решал, какие результаты валидны, достаточен ли сигнал и что строить дальше.
AI помогал исследовать альтернативы, критиковать гипотезы, разрабатывать протокол, реализовывать и рефакторить benchmark, автоматизировать прогоны и искать дефекты методики. Финальная интерпретация оставалась за мной; другой человеческой команды не было.
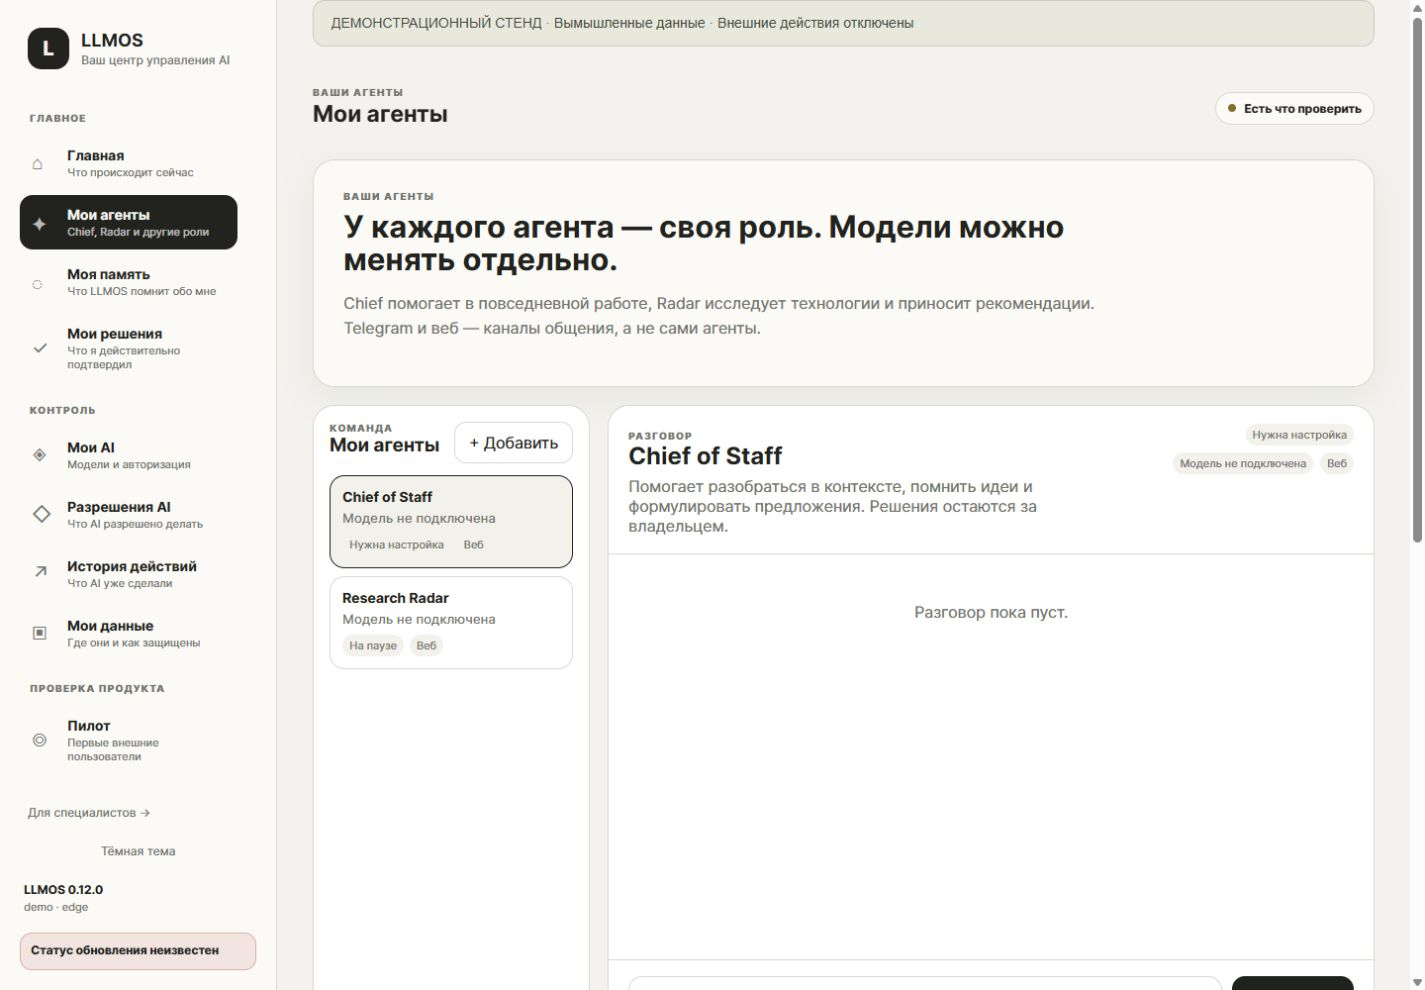
ChatGPT — discovery, критика, экспериментальный дизайн и интерпретация. Codex и coding agents — код и проверки. DeepSeek — модель автоматизированного benchmark. Hermes — внешний агентный runtime для экспериментов с Chief, Radar и интеграцией механизмов LLMOS.
Использование ChatGPT и Codex не означает партнёрства или совместной разработки с компанией OpenAI.
Инженерный этап и материалы
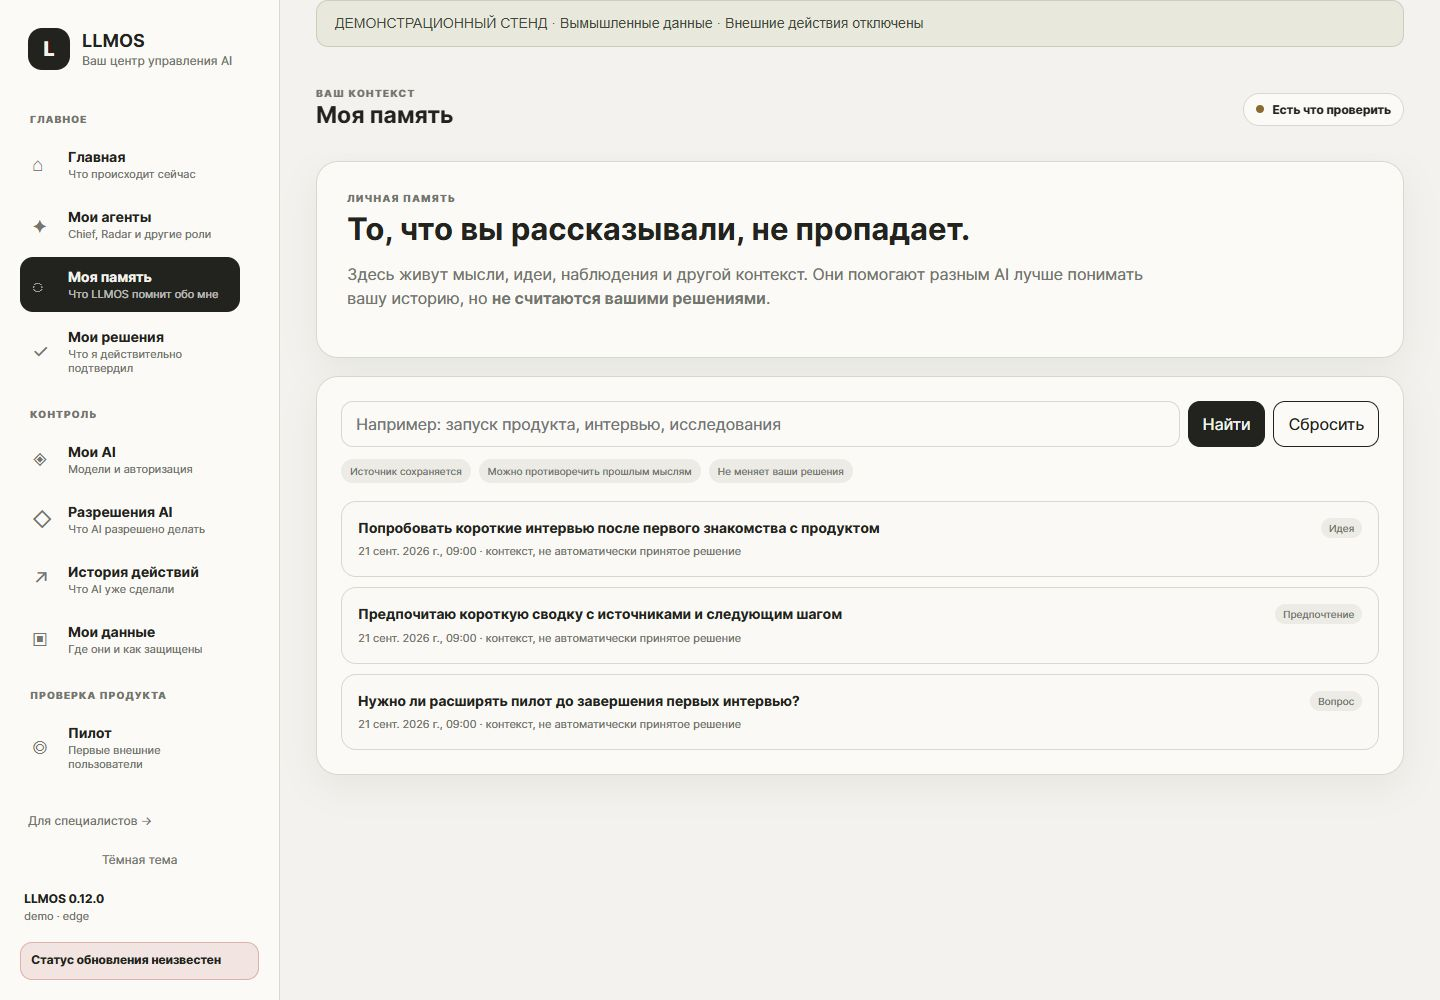
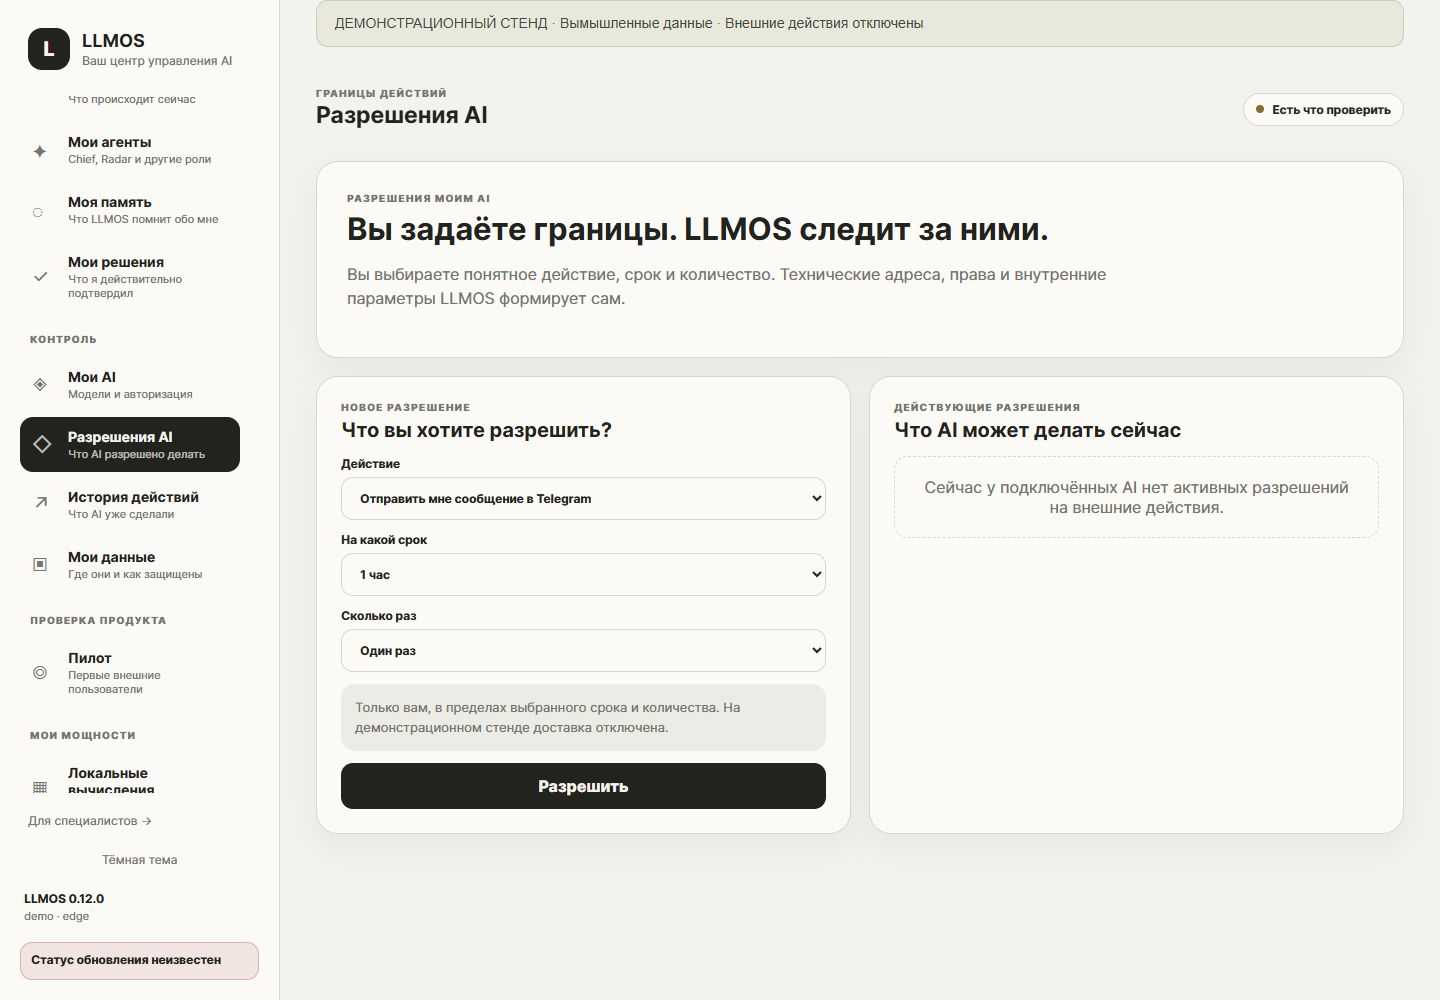
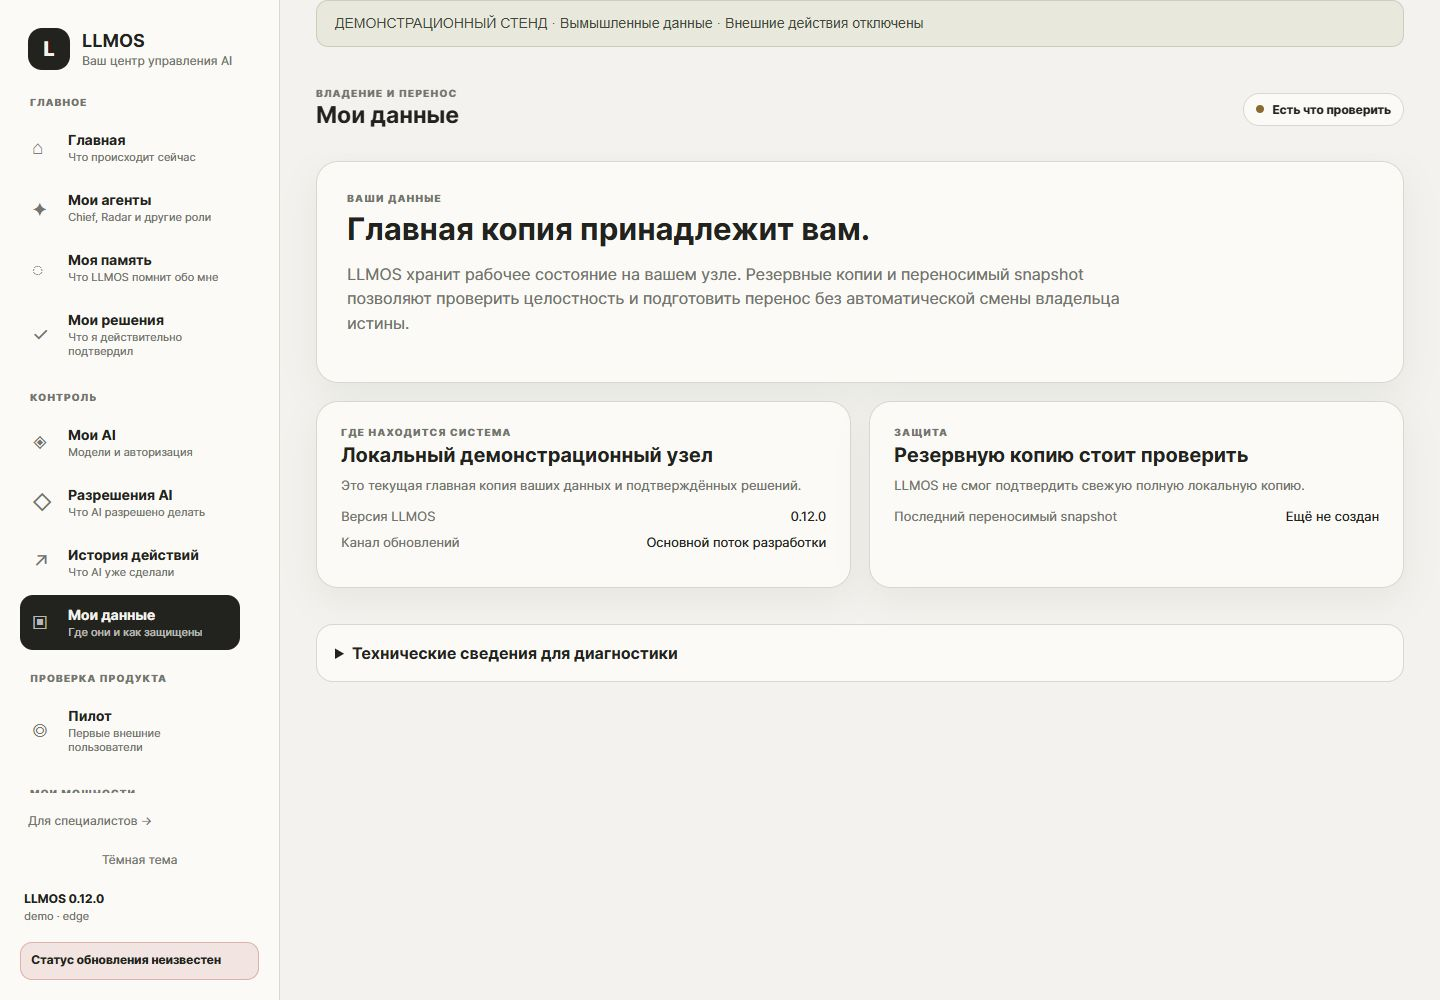
Platform 0.12.0 — инженерный R&D-этап. Его интерфейс показывает отдельные области памяти, решений, разрешений, агентов и данных. Для портфолио экраны восстановлены из исходного кода на локальном стенде с демонстрационными данными.
Техническая основа этого этапа: Node.js, PostgreSQL, MCP, Docker Compose и Caddy. Hermes используется как внешний runtime, не как собственная технология LLMOS.
Скриншоты подтверждают состояние интерфейса. Они не доказывают эффективность гипотезы или готовность платформы к коммерческой эксплуатации.
Текущая граница результата
LLMOS остаётся проверкой гипотезы и исследованием. У проекта нет внешних клиентов, PMF или доказанного универсального преимущества.
Проблема → гипотеза → эксперимент → первый сигнал → строгая проверка → частичное опровержение → изменение направления.